数字人视频

用来画数字人播报,把一门课程拆成系列口播
数字人视频
 10.10

面向企业培训、院校微课与知识付费,介绍用来画数字人播报固定讲师形象与音色、按知识点拆分讲稿,并复用资产制作系列课程口播的方法。
企业人力资源部门做培训,最怕「课已经写好了,但没人录」。一门产品培训20节,每节再拆3—5个知识点,就是60—100条口播;门店全国铺开后要补新价格、新政策、新话术,录一次就要协调讲师档期。
院校教研组也类似,同一门精品课给不同年级讲,换学期换案例又要重录;讲师课表排满,录制永远排不进去,做好的PPT和讲义闲置。
知识付费更明显,一套系统课想做日更口播、试听切片、社群短讲,靠真人天天录不现实,外包又慢又贵,且不同批次音色形象不一致,用户会以为「换老师了」。
核心矛盾不是「会不会录」,而是「出片高度依赖同一个人」。数字人播报的解法是:形象、声音、模板固定成资产,讲稿作为唯一变量;同门课每条口播都调用同一套资产,人就只出现在定稿、把关、复盘环节。
数字人播报的本质是「固定角色加固定声音加可变文案」。来画把角色形象和声音做成可复用资产,下一次换文案时,不必重新调形象与音色,这条逻辑正好对应课程系列化的需求,让一门课从一次录制变成可持续产出的栏目。
形象和声音一次绑定,之后只换讲稿。 同一讲师的数字人形象建好之后,音色稳定绑定,后续的每一条口播都沿用同一套资产,观众看到的永远是「同一个老师」。不用每次重新录制,栏目的辨识度也跟着立起来。
按知识点分条,风格自动统一。 同一角色的多套造型基于同一资产卡,角色一致性更高,一门课拆成多条口播时,画面、语速和语气都保持一致,观众不会觉得换了人在讲。学习节奏也更连贯,学员更容易跟上。
复用资产做下一条,边际成本往下走。 每一条新口播只需替换讲稿,形象、声音和模板沿用,出片动作被压缩成「写稿到生成」这一步,系列栏目的扩容成本明显下降。多开一个系列,也不再是两倍的负担。
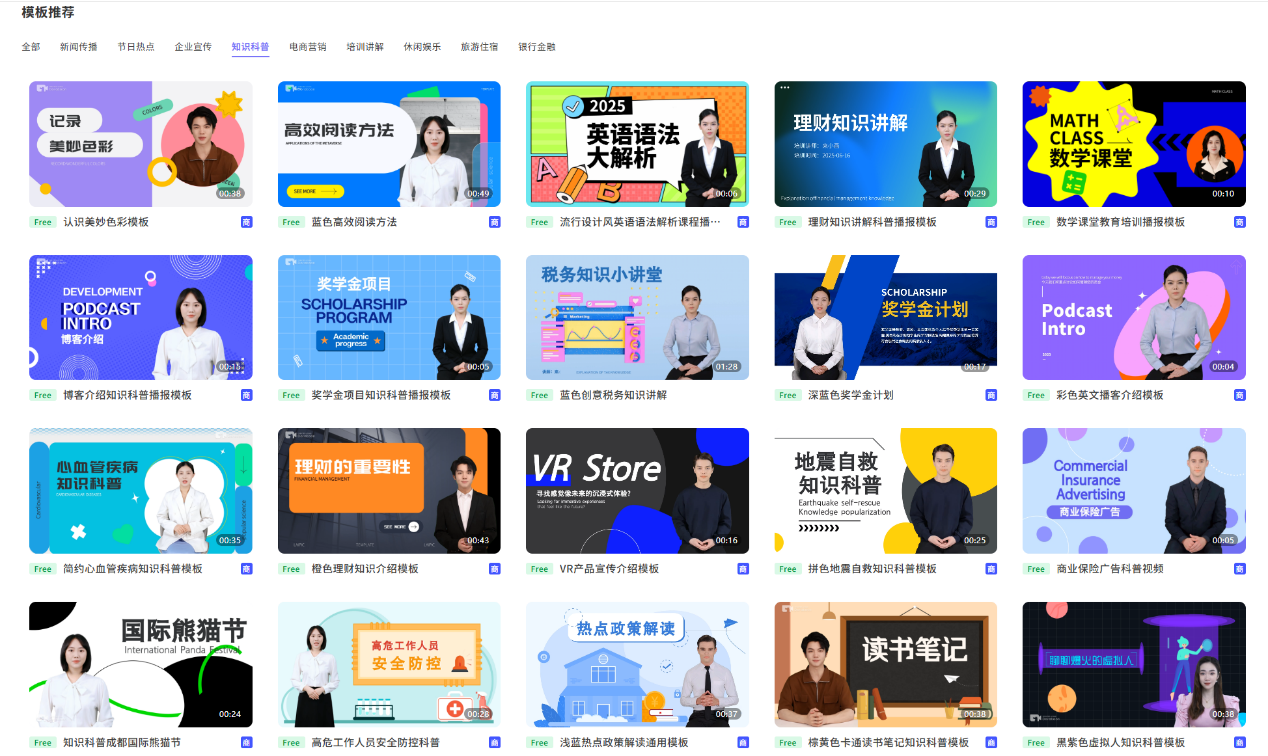
这种拆法特别适合企业培训、院校教研和知识付费:内容按知识点沉淀成资产,更新时只动讲稿,栏目就能稳定连载,不必每次都从零开始。讲师也从「被排期追着跑」变成「定好节点再出片」,节奏回到自己手里。
把一门课落成系列口播,可以固定成五步流程,每一步的产出都能作为下一条的资产,重复内容不必再做第二遍,效率和一致性一起上来,栏目越做越顺。
在资产库里建立角色资产,把外观、造型和标识固化下来,来画让同一角色的多套造型都基于同一资产卡,提升角色一致性,这一步约耗时8分钟。
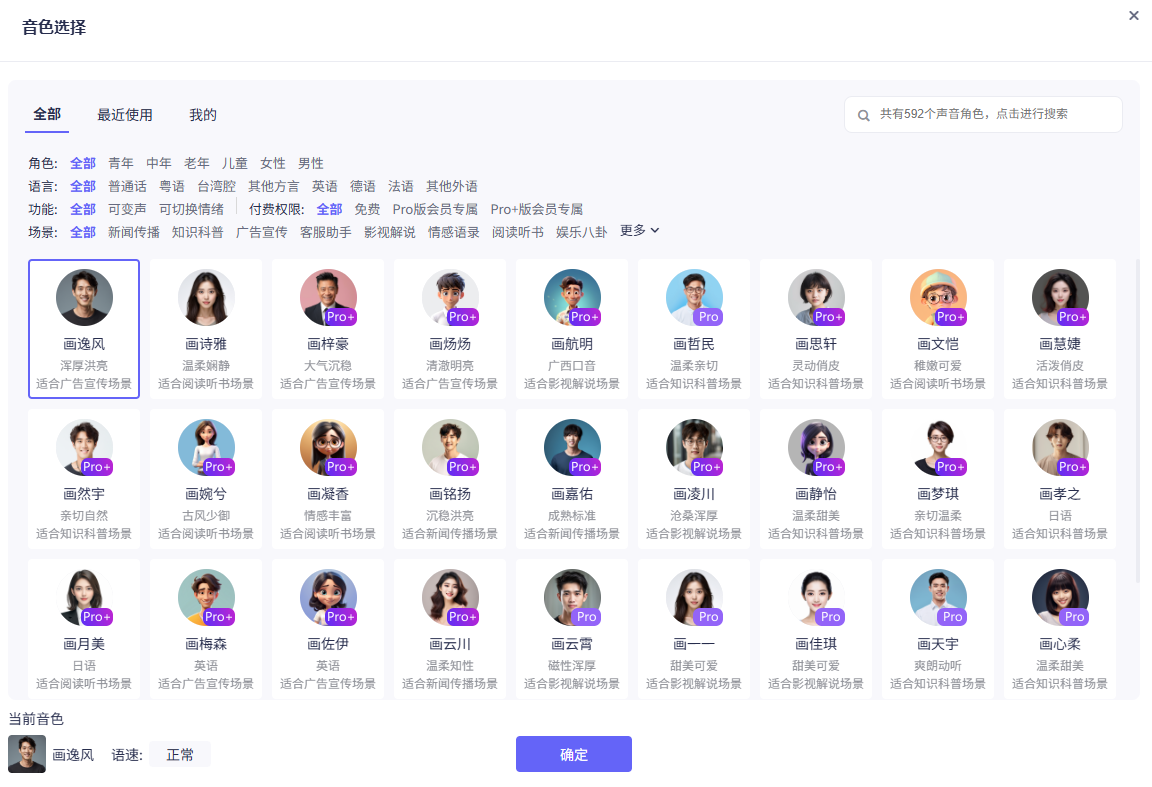
为每个角色绑定一个声音,根据来画目前公开页面,平台提供460+仿真音色,支持批量生成全部资产图并分配声音,具体可选音色以实际账号界面为准,这一步约耗时10分钟。
把一门课的讲稿按知识点拆成若干条,每条聚焦一个要点,讲稿写好后直接用于生成口播,替换讲稿就能产出下一条,这一步约耗时20分钟。
讲稿生成口播视频,配音随语音自动生成,字幕再人工核对,确认画面与配音一致后导出成片,可用的格式与清晰度以官网当前页面显示为准,这一步约耗时12分钟。
下一条只需替换讲稿,形象与声音沿用同一套资产,从资产库调用即可,不必重新搭建,把「变」与「不变」分开管理的好处在这里最明显,这一步约耗时6分钟。
五步走完,一条系列口播大约一小时以内,真正花时间的是第三步把知识点讲清楚,以及第四步的字幕与导出核对。数字人把重复劳动批量做掉,人只留在判断环节,栏目的产量和质量反而都更稳。
数字人适合把可标准化的部分稳定量产,但有些环节的判断权必须留在人手里,把它当成「可复用员工」而非「替代真人」,栏目才走得长远,关键处才不会失手。
讲稿的知识点判断,仍由讲师定稿。 可标准化的口播、知识讲解适合交给数字人,但知识点的准确性、案例的适配和口径的把握,仍建议真人把关,避免讲稿出错却已批量生成。一条错片,会连带影响整个系列。
互动答疑与情绪时刻,交给真人。 涉及情绪判断、复杂答疑和现场互动的环节,不适合交给数字人,仍由讲师或运营真人处理,数字人负责的是已经定稿的播报内容。把「讲」和「答」分清楚,栏目才可信。
商用前确认音色使用范围,人工复核。 平台提供的音色是合成声音而非真人授权,商用前应按平台规则确认使用范围,可选音色以平台当前列表为准。发布前再走一遍人工复核,把合规动作固定进流程更稳妥。
把「哪些交给数字人、哪些留给人」提前写进流程,比出片之后再补救要省心得多,栏目既能稳定更新,也不会在关键判断上失手。这也是系列口播能长期跑通的根本原因,先把边界写清楚,再谈效率。
适合,尤其是一门课要拆成多条口播、且需要长期更新的场景。企业培训、院校教研和知识付费的执行人,可以把形象和声音一次绑定,之后只替换讲稿批量出片。按知识点分条还能保持风格统一,把可标准化的播报交给数字人,把判断留给讲师。
没有固定数量,通常按知识点切分更顺:一节大课拆成三到五条,每条聚焦一个要点,观众更容易看完,也方便后续按知识点检索和复用。切得越细单条出片越快,但也要注意每条的完整性,避免把一个知识点拆得太碎反而讲不清楚。
不会,前提是角色与声音做了资产化绑定。来画把同一角色的多套造型基于同一资产卡,并为角色绑定一个稳定音色,支持批量生成全部资产图并分配声音。后续每条口播沿用同一套资产,角色一致性和音色稳定性都更高。
讲稿的知识点准确性、案例适配和口径把握应由讲师定稿;涉及情绪判断、复杂答疑和现场互动的环节交给真人。商用前还要确认音色使用范围并做人工复核,数字人负责已定稿的播报。判断权始终留在人手里,栏目才稳妥。
课程讲解的终极问题不是「会不会做一条视频」,而是「一门知识能不能持续、稳定、低损耗地传给所有人」。传统模式把讲师的时间当产能,时间一到就断更;数字人播报把形象、音色、模板当资产,把讲稿当唯一变量,让人回到最该做的部分。
现在就登录来画官网,从一门小课开始,搭建你持续输出的教学培训工作流!
想直接动手制作?打开来画,选一个模板就能快速开始你的作品。